
SCA-L端到端模型实验报告
我们在Tiny Shakespeare数据集上训练了一个基于SCA-L的端到端模型,该模型在该数据集上表现接近标准Decoder-Only Transformer。
实验数据
所有都是在latent_dim=4时测得,直接上图表吧。
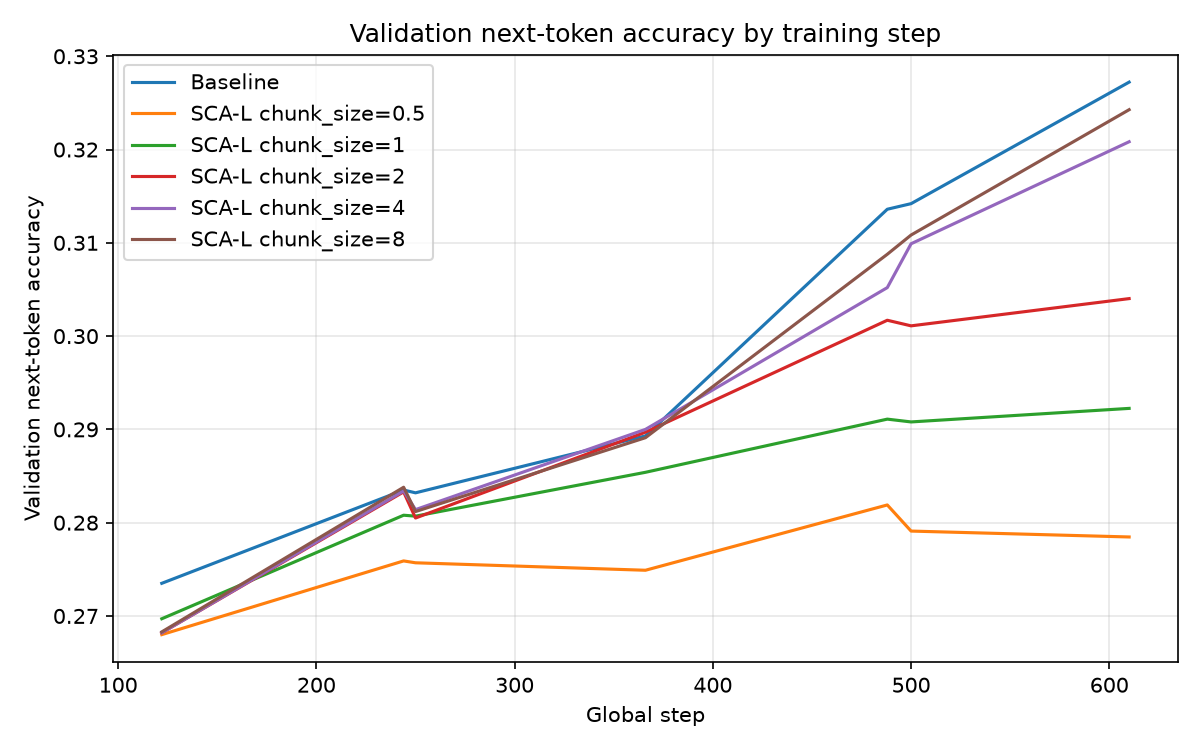
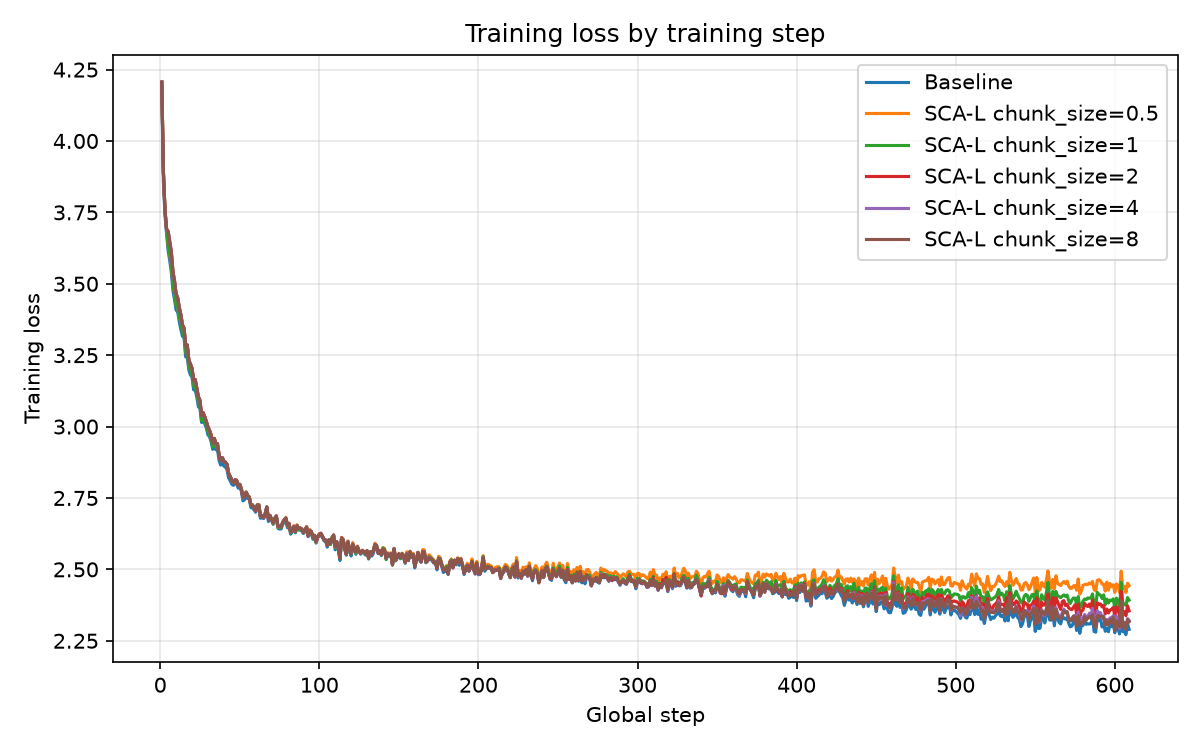
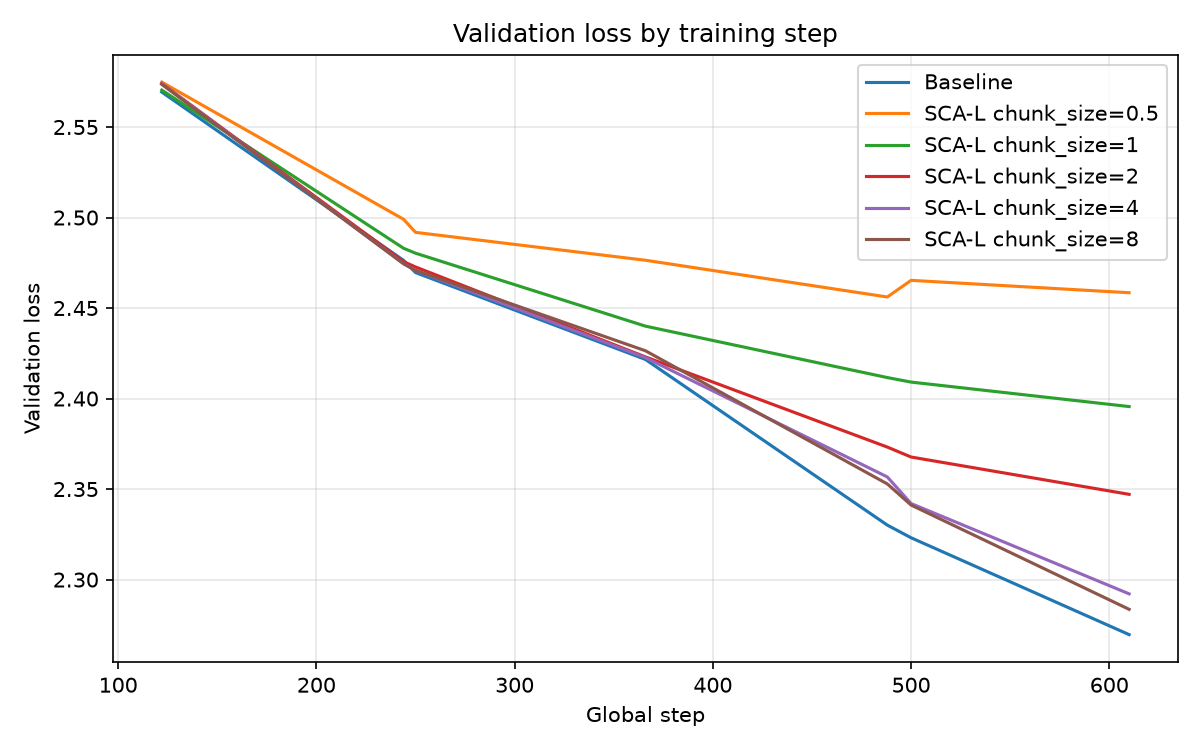
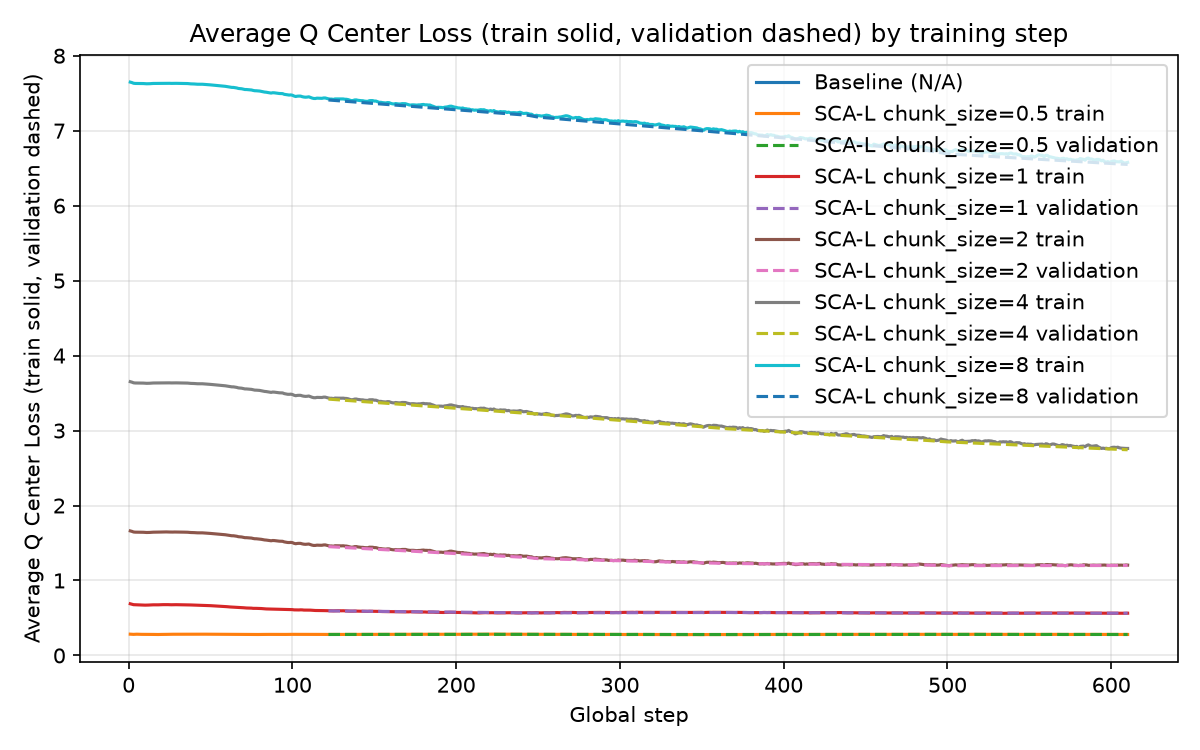
这个线性层起的效果太好了,看起来它完全具备标准Decoder-Only模型的能力,但是理论时间更优。
实际时间我也不知道是不是AI实现的问题,Baseline实际比他快太多了。应该是因为Baseline已经经过很好的CUDA内核级优化,但是这个没有,那就没法比,没有参考意义。
结尾
代码可下载供复现。
评论
评论插件加载失败
正在加载评论插件