
对SCA的端到端模型训练实验
我们在Tiny Shakespeare数据集上训练了一个基于SCA的端到端模型,该模型在该数据集上表现劣于标准Decoder-Only Transformer。
背景
我们提出了SCA,我迫不及待的进行端到端模型训练试验。
过程
我们在AutoDL上租了一个vGPU-32GB显卡的服务器,用Space Bunny Alpha在服务器上捣鼓了一个实现(免费的就是香)。
图表
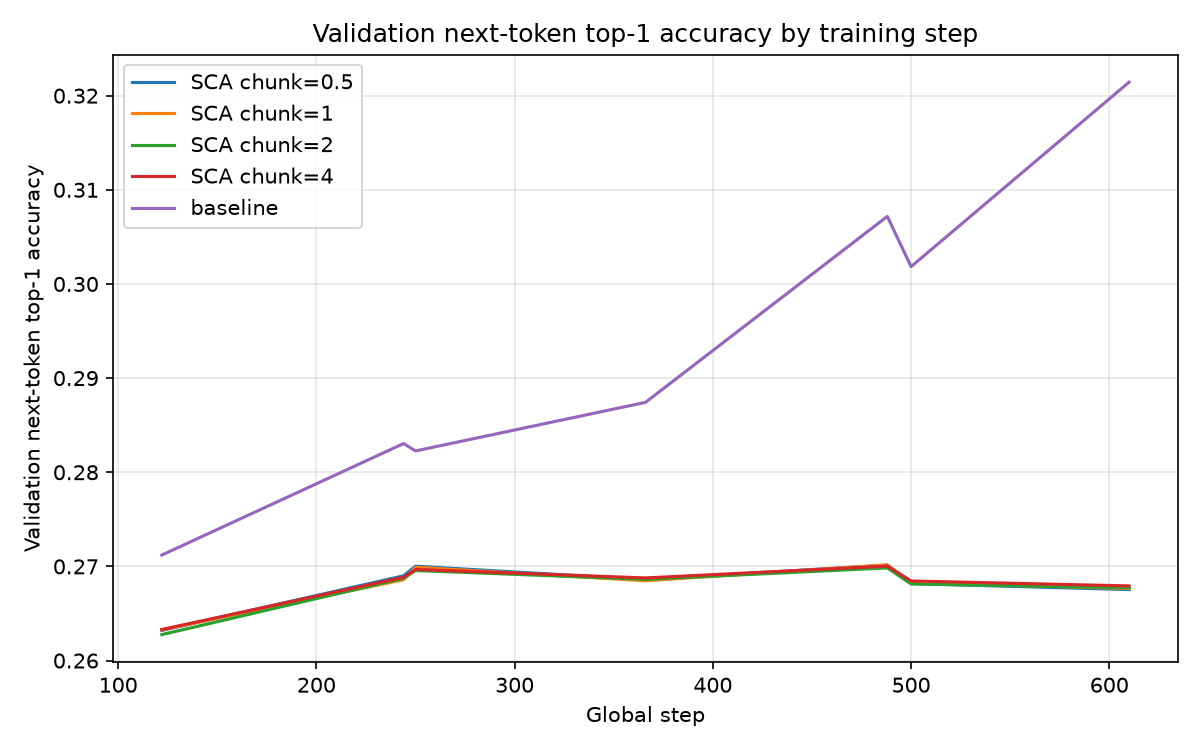
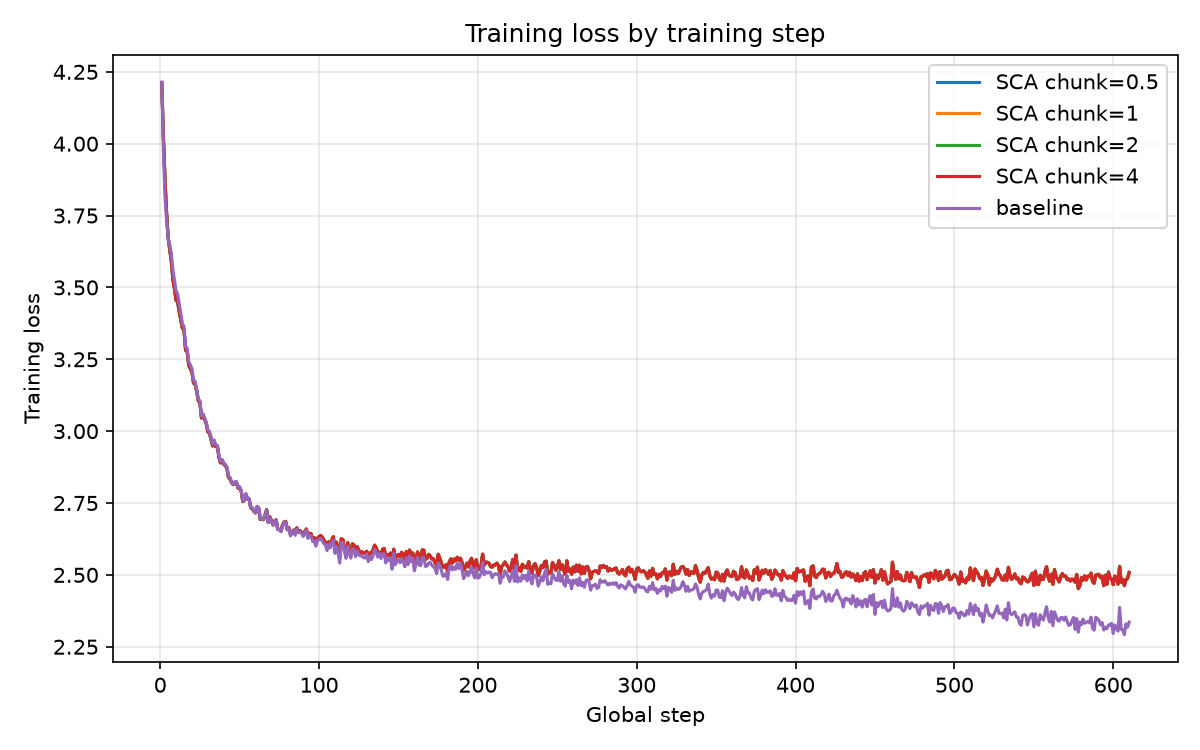
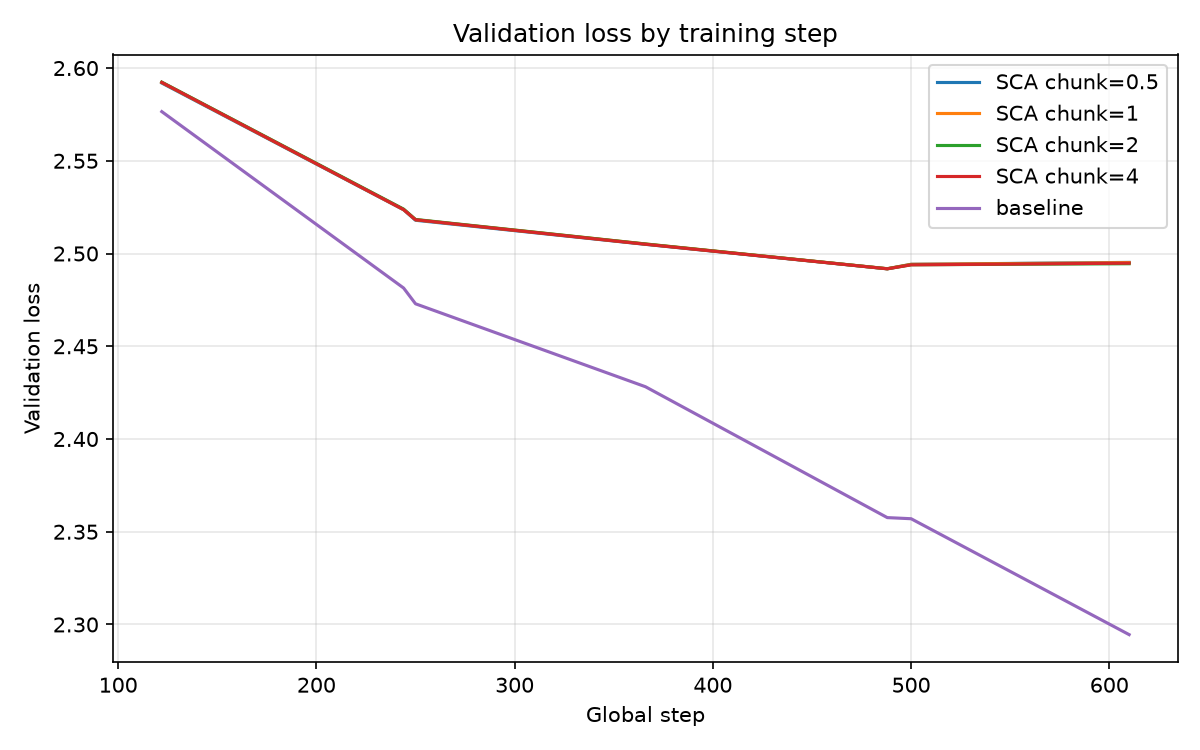
我们可以看到,准确率和验证集loss上SCA明显劣于Baseline的标准Decoder-Only Transformer,我猜测是因为16维过于稀疏。并且注意到准确率、训练loss、验证loss里的各chunk_size对结果影响并不大,甚至可以说是重合,可以基本排除chunk_size作为超参数可能导致的影响。
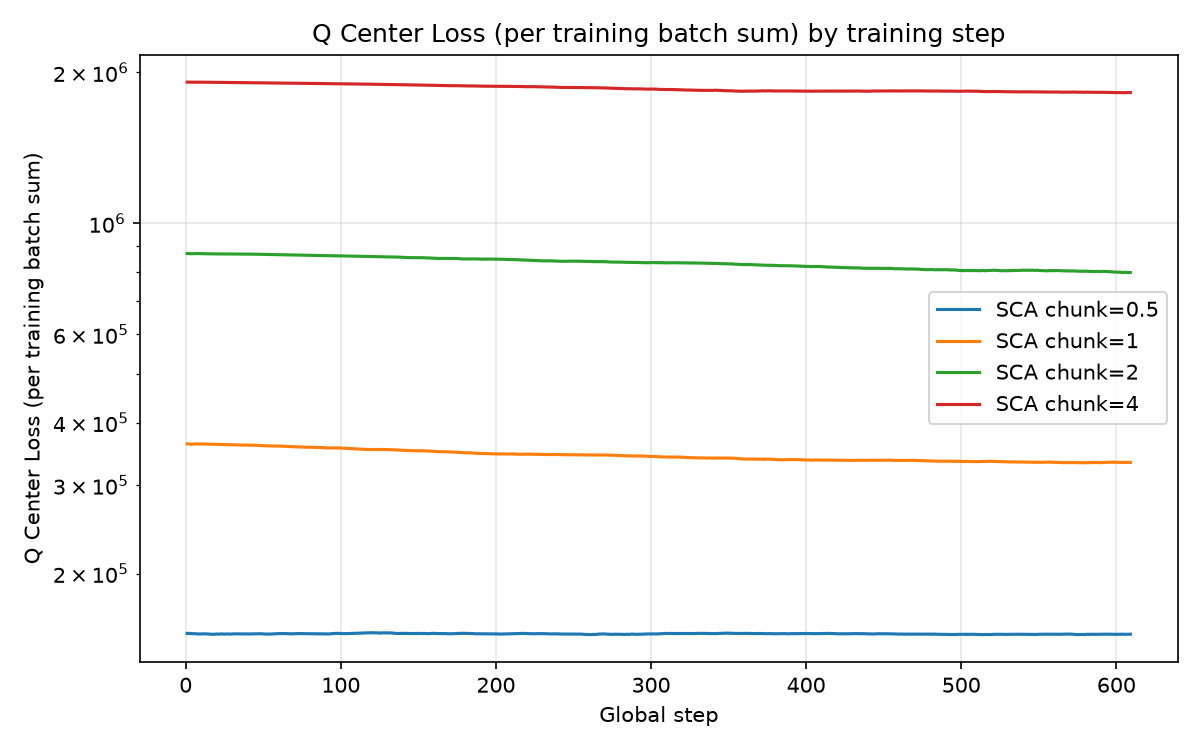
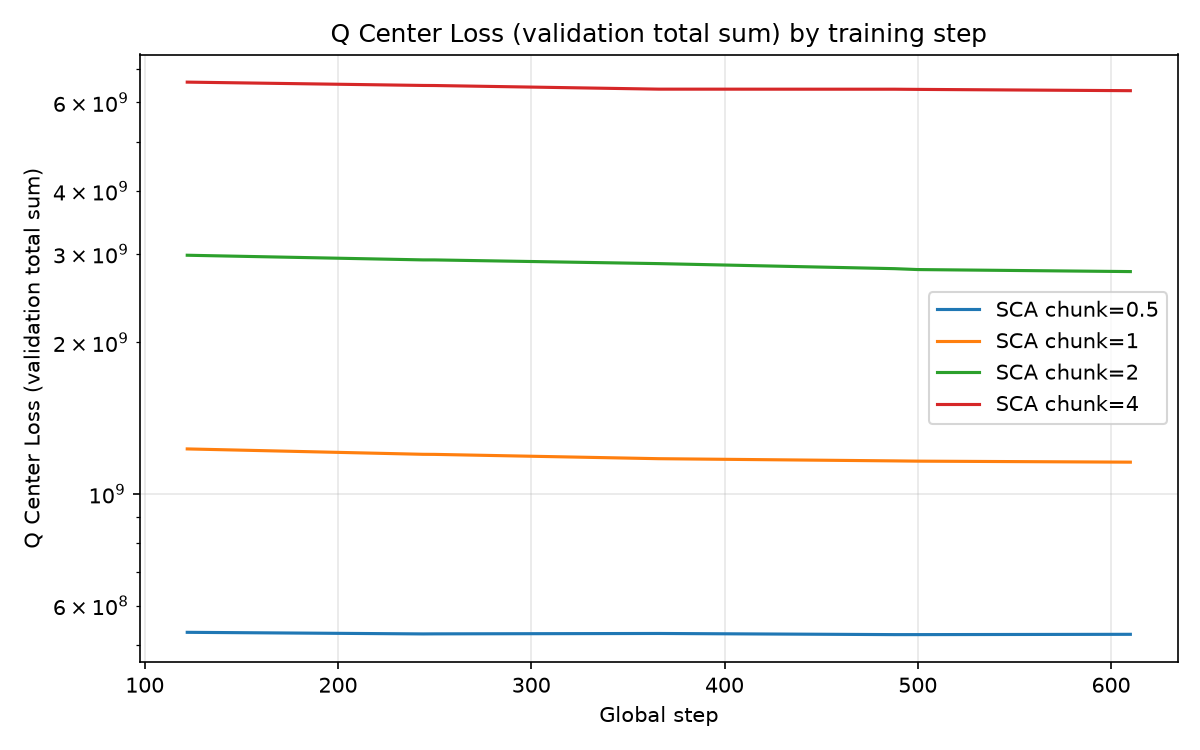
Q Center Loss
这是我自己搞的一个指标,注意,我并没有让他参与梯度计算,这只是一个指标。它代表所有Q向量到它所在块的中心的距离之和,因为数量极大所以我的图表中是对数尺度。
你可以看到该指标虽不太明显但稳定的下降痕迹,证明了我在上篇文章的推论。
结语
我可能进行进一步架构改进或实验。代码可复现。
评论
评论插件加载失败
正在加载评论插件