
提出了一种没有门控的极简全新RNN架构。
前言
我在尝试用RNN做一个比Transformer好的语言模型(当然这近乎不可能),然后我在语文课上想到了这个架构(语文课可以想出除语文题外的任何事情,,,)。
它怎么工作
DESER 的核心就一句话:用一个向量 P 来记东西,用另一个向量来读它。
每一步预测下一个token,把当前token的embedding 和候选token的embedding 拼起来,跟P点积:
不用Linear做读出,logits 直接出。P的前 维和 交互,后 维和候选交互。
P 的更新就是最简单的渗漏积分(leaky integration):
是 Linear(d, 2d) + GELU,每个时间步从当前 token 算出一个 delta 塞进 P。旧的值乘 衰减。
没了。没有 sigmoid,没有 softmax,没有 gate。
试验
Adding Problem
一串随机数,随机挑两个标 1,求和。测的是长程依赖。
结果: 最优。加法问题丢了任何一个数都白干。L=100 时 MSE 约 0.002,LSTM 约 0.022。
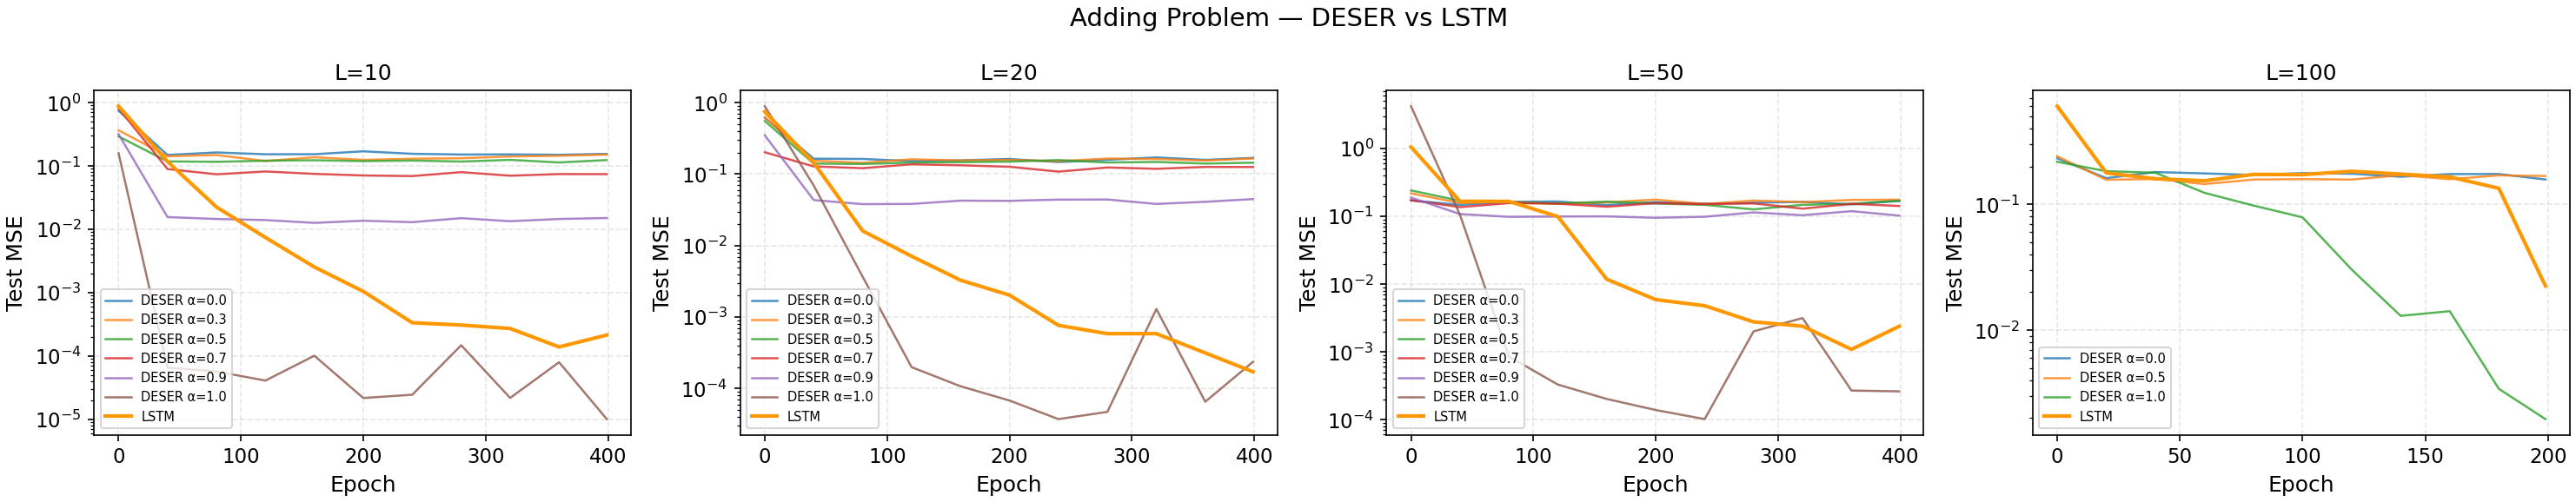
但这个比 LSTM 低不说明 DESER 更厉害——回归任务本来就和无门控加法对味。
Copy Problem
给一串 token,中间插分隔符,原样输出。测记忆。
结果:0% 精确匹配,全部 一样。
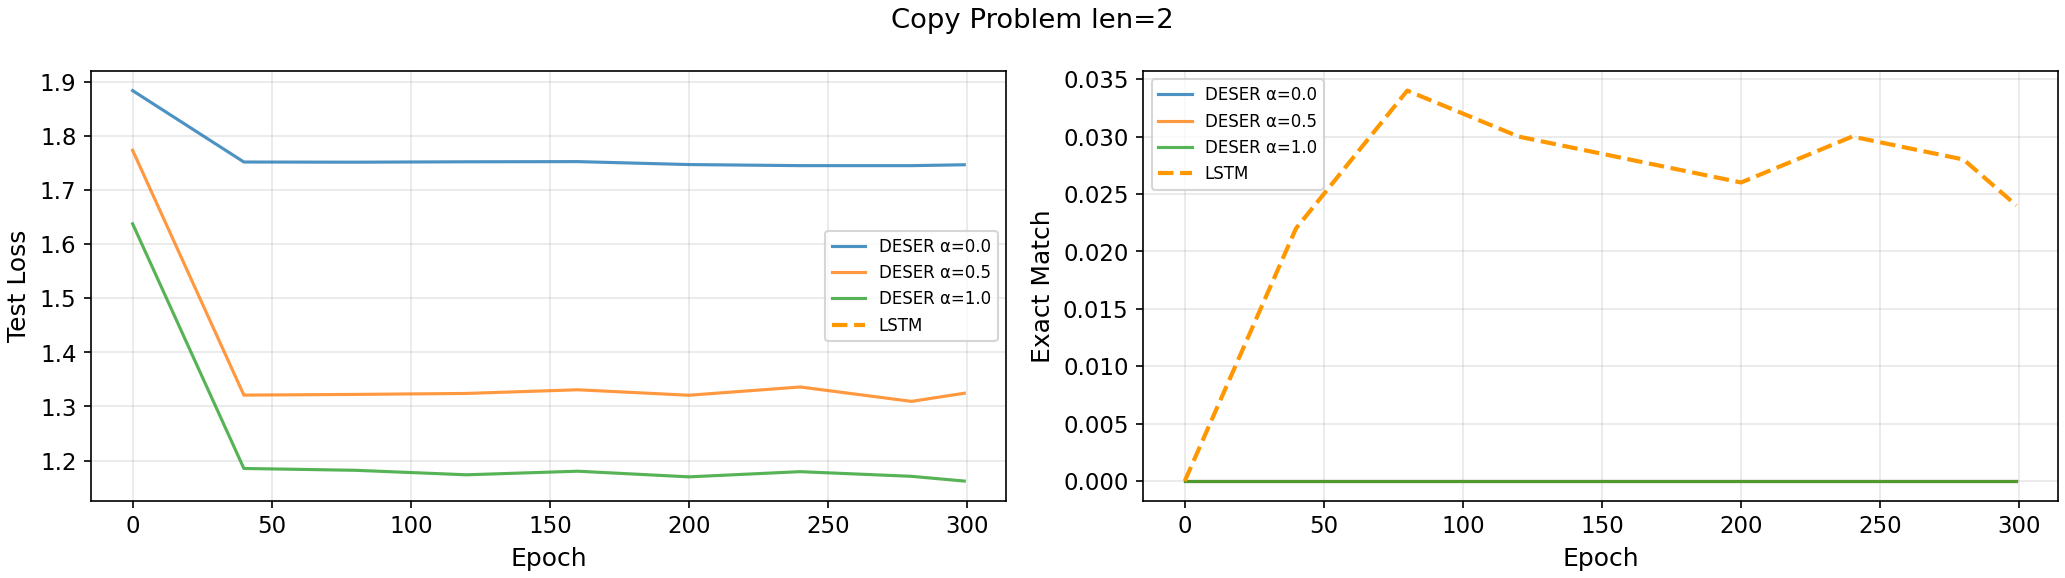
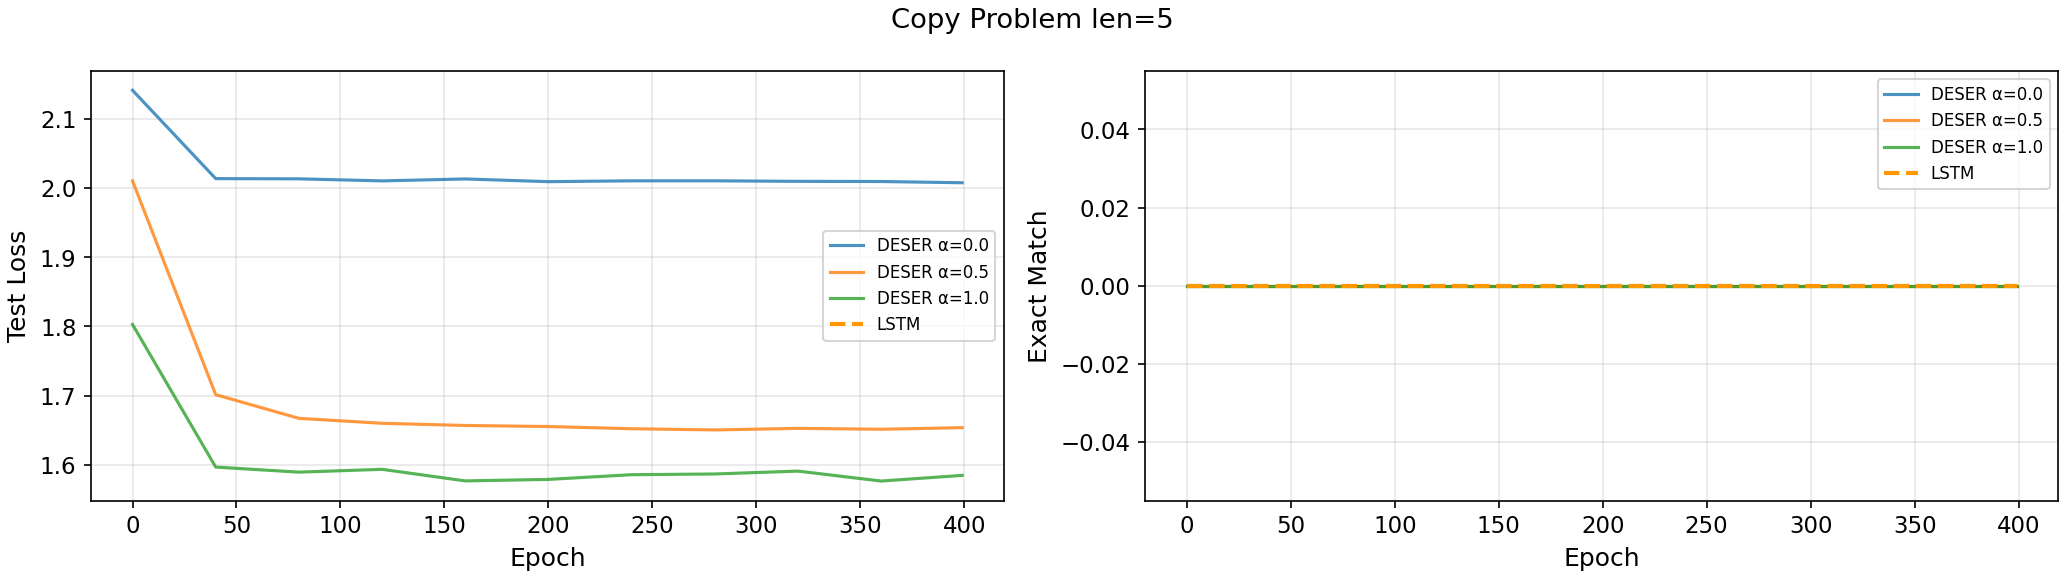
P 是个向量,所有 token 的 delta 全叠一起,不是按顺序存的。你说能从里面读出"出现过 token 2",但 2 前面是几后面是几,它不知道。LSTM 在 copy_len=2 能到 ~2%。
Char LM
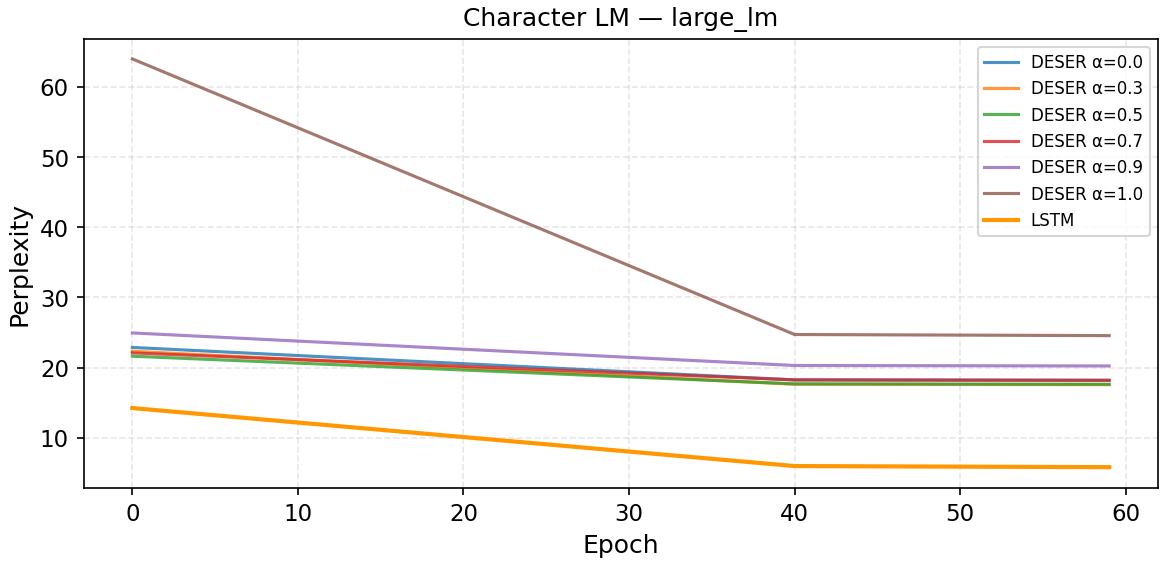
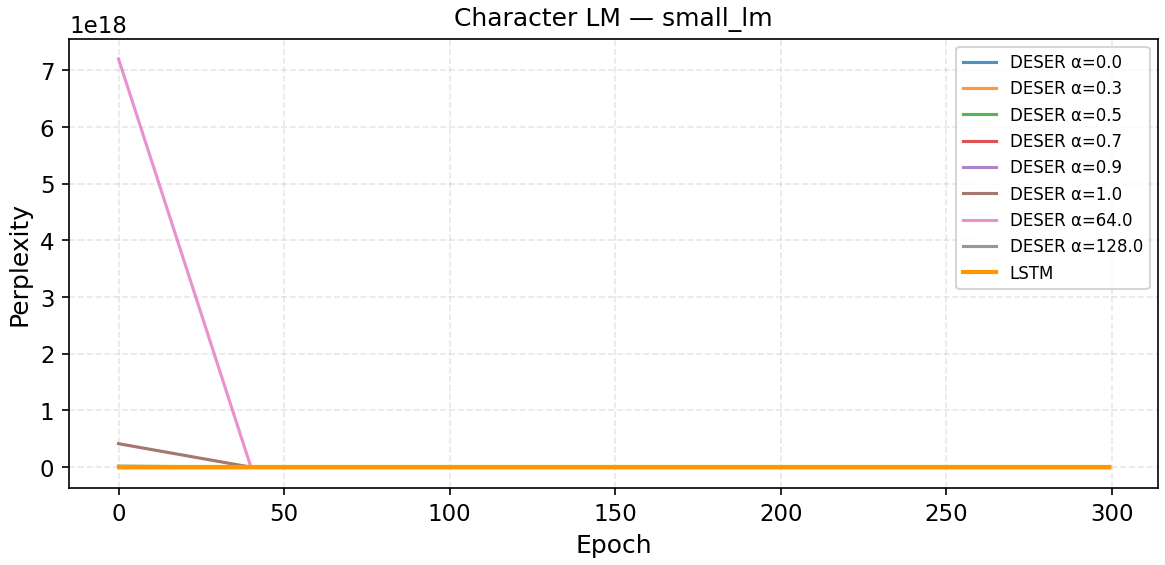
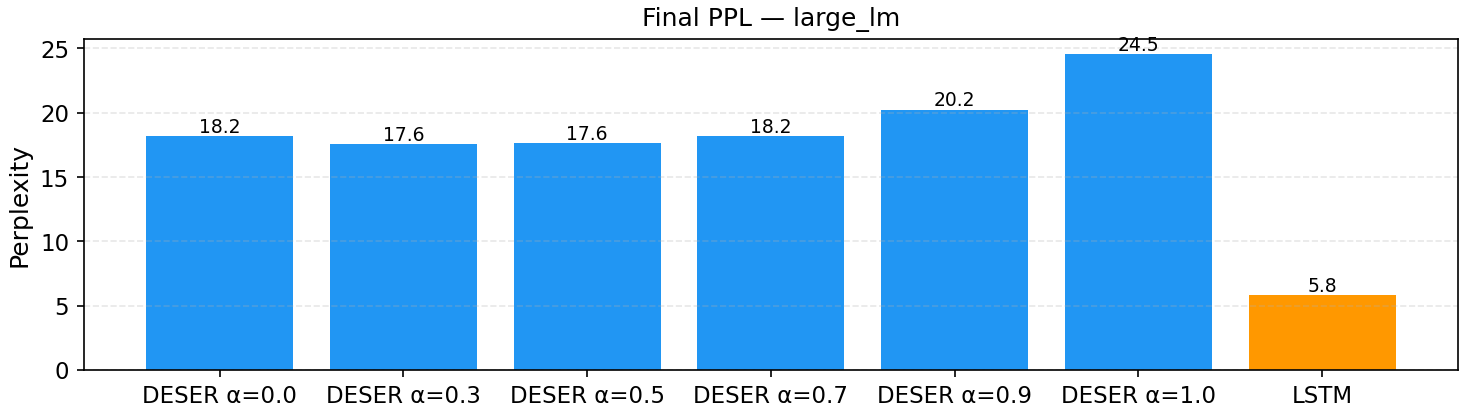
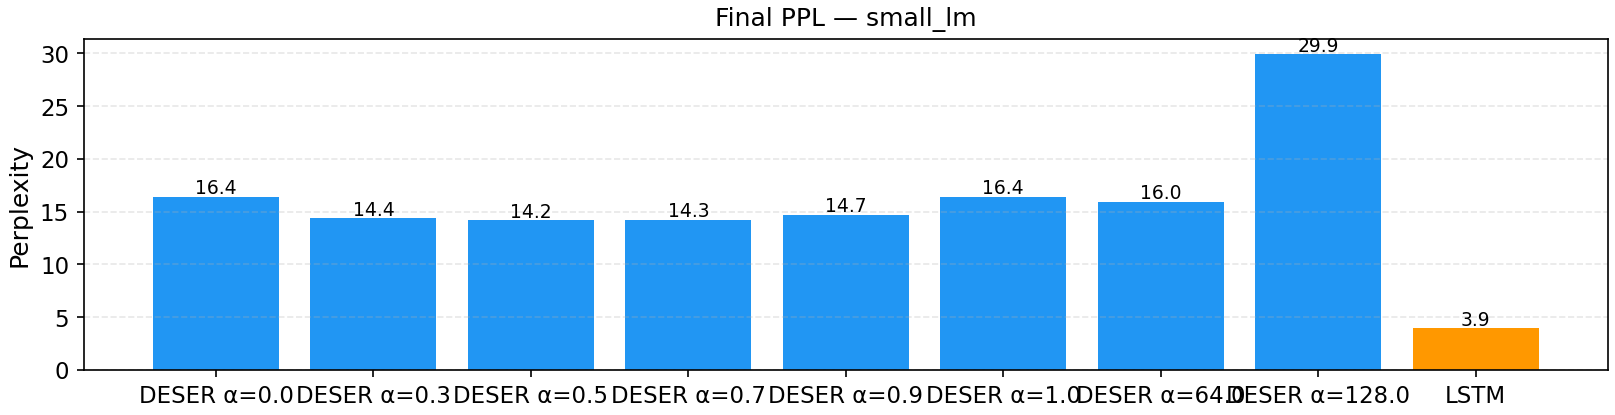
TinyShakespeare,前 50000 个字符,vocab=59,d=32,seq_len=64。六个 ,300 epoch。
最好的 ,PPL 15.9。同参 LSTM 是 5.9。
约等于只记住前两三个 token。再长就被噪声盖住了。
后来又试了几个改进:
- 加二元矩阵 W:score 多了一个
prev @ W @ E(i)项,W 是静态矩阵不参与 P 的更新。PPL 从 15.9 掉到 14.19()。W 走独立通道不受叠加干扰——本质是个学出来的 bigram。 - 扩 d:32→64→128。PPL 从 14.19 到 13.59 就停了。不是参数不够。
- 双通道 P:一条 一条 ,各自更新。PPL 14.44,比单通道还坏
为什么打不过 LSTM
加性叠加没有选择。
LSTM 的 forget gate 按维度选择性忘——这个维的历史没用就扔,有用留着。input gate 同理——写不写进去按维决定。
这就是老资历的智慧吗,,,果然门不是可以遗弃的。
DESER 只有一个标量 ,所有维度一个衰减速率。你没法区分"这个东西要记住"和"这个是噪声赶紧丢"。
所以: 最好(再长就是噪声)、Copy 0%(叠加态保不住顺序)、扩 d 没用(不是容量问题)、双通道没用(多一条路又不能帮你挑)。
顺便一提
opencode+deepseek v4 pro真的不错,是由它们实现的代码,我也让他们生成了一篇小论文